LoRA / 微调要不要上 A100?什么时候 4090 就够
先给结论
多数图像 LoRA、轻量微调,先租 RTX 4090(约 ¥1.19–3.12/小时)把流程跑通;24G 反复 OOM、更大基座、需要更稳的长训,再上 A100(PCIe 约 ¥4.17–6.27/小时,SXM 约 ¥4.86–6.27/小时)。
不要因为「训练」两个字就默认数据中心卡——先证明 4090 不够,再为显存与吞吐付溢价。
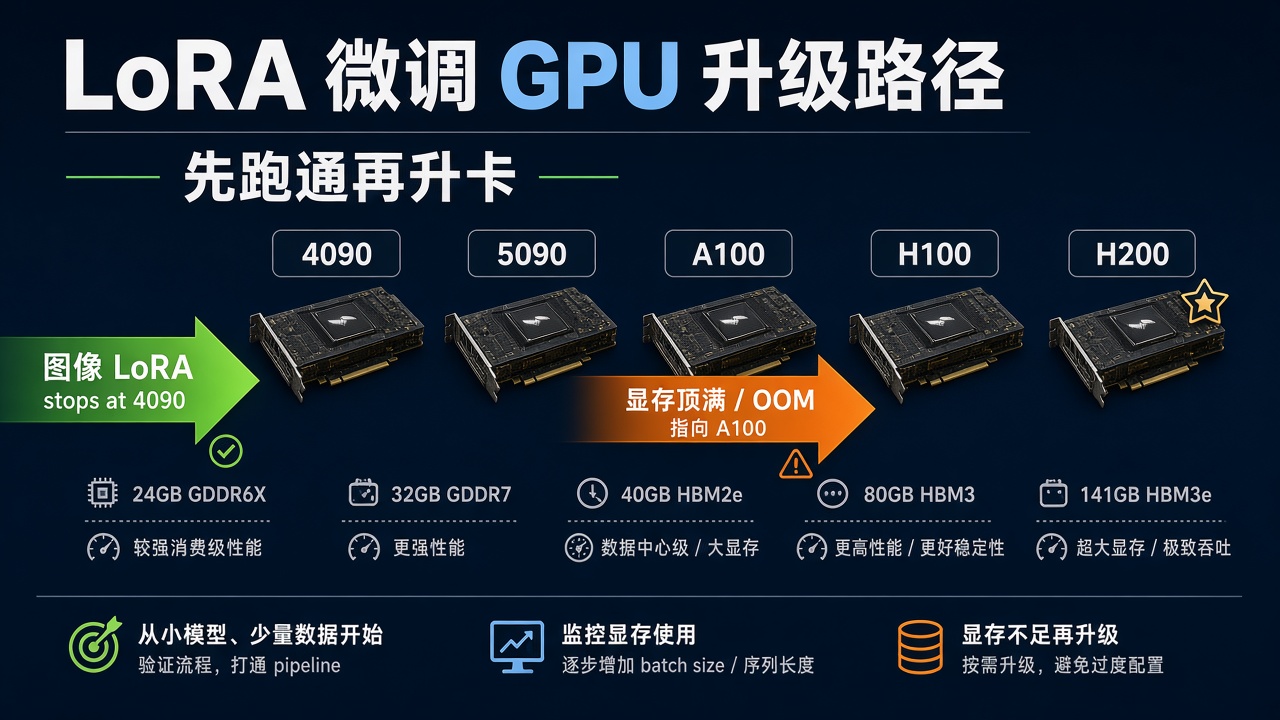
本文回答「LoRA / 微调要不要 A100」。出图选型见ComfyUI/SD 出图租哪张卡。价格均为社区云→安全云区间快照,以创建页实时为准。
先跑通
RTX 4090
¥1.19–3.12 /小时
图像 LoRA / 轻量微调甜点
显存顶满再上
A100 PCIe
¥4.17–6.27 /小时
SXM 约 ¥4.86–6.27 · 社区云→安全云 · 以创建页为准
决策表:负载 → 卡
| 负载 | 更稳妥起点 | 小时价区间(示意) | 何时升级 |
|---|---|---|---|
| 图像 LoRA / 风格微调 | RTX 4090 | 约 ¥1.19–3.12/小时 | 24G OOM、batch 被迫过小 |
| 流程未跑通的试错 | RTX 4090(或 3090) | ¥1.19–3.12(¥0.77–1.75) | 脚本稳定后再谈升卡 |
| 更大显存余量的同档消费级 | RTX 5090 | 约 ¥2.42–4.17/小时 | 仍偏消费级;库存可能紧 |
| 中大型微调、80G 档工作马 | A100 PCIe / SXM | 约 ¥4.17–6.27 / ¥4.86–6.27 | 4090/5090 显存或时长不划算 |
| 更高吞吐新一代训推 | H100 NVL / SXM | 约 ¥9.06–11.16 / ¥9.41–13.96 | A100 吞吐不够时 |
| 更大显存 / 长上下文 | H200 | 约 ¥12.56–18.52/小时 | 80G 顶满再上 |
为什么「先 4090」对 LoRA 常成立?
- LoRA 吃的是可训练参数子集,不是每次都要从头堆满数据中心显存。
- 试错小时很贵的是「环境 + 数据路径」,不是卡徽标。低单价卡上先把 loss 曲线跑出来,总账往往更省。
- 升 A100 的正确理由是显存 / 时长算术,不是「听起来更专业」。
预计小时数 × 创建页小时价。若 4090 要跑很久,而 A100 显著缩短且总价更低,再升;若只是快一点但总价更高,且 4090 并不 OOM,就留在 4090。什么时候值得上 A100?
- 24G(或 32G)反复 OOM,降 batch / 序列长度已经伤害效果。
- 基座更大,消费级卡只能「勉强挤进」导致频繁失败。
- 需要连续较长训练,更在意稳定吞吐;可同时考虑安全云档(见安全云 vs 社区云)。
- 同实验要多卡(2/4/8)做并行,数据中心卡生态与显存余量更好规划。
还不够再看 H100;显存仍顶满再看 H200。跳级只会让账单先疼。
A100 PCIe 还是 SXM?
PCIE
A100 PCIe
约 ¥4.17–6.27/小时。预算紧、单卡微调常见起点。
SXM
A100 SXM
约 ¥4.86–6.27/小时。更看互联 / 同代训练吞吐时。
两端都按小时计费;用完停止;磁盘另计。持久化场景可能需删除才停 GPU 费——见停机还在扣费。型号页:A100 租用。
图像 LoRA vs 语言模型微调
| 类型 | 常见起点 | 何时离开消费级 |
|---|---|---|
| 图像风格 / 角色 LoRA | RTX 4090 | 分辨率、batch、多概念把 24G/32G 打满 |
| 轻量脚本、短 epoch 验证 | 4090 或甚至 3090 | 验证完再升,避免用 A100 调试路径 bug |
| 更大 LLM LoRA / 长序列 | 更常直接评估 A100 | 消费级只做 tokenizer / 小步冒烟测试 |
| 全量微调或超长上下文 | H100 / H200 阶梯 | 80G 仍紧再上 H200 |
「我在微调」≠「我必须 A100」。答不清时,用 4090 做冒烟训练(几步即可),看 OOM 再决定。
总时长算术示例(示意)
同一实验估计需要有效训练 8 小时(已含偶发失败重跑):
| 卡 | 假设创建页价 | 8 小时示意 | 备注 |
|---|---|---|---|
| 4090 | ¥2.0/小时 | 约 ¥16 | 若不 OOM 且 8h 可接受 |
| 5090 | ¥3.2/小时 | 约 ¥25.6 | 仅当显存余量换来更少失败 |
| A100 | ¥5.5/小时 | 约 ¥44 | 若能把墙钟砍到一半,再重算 |
实操:最小浪费路径
单卡 4090
训练模板跑通数据与保存逻辑(社区云即可)。
记算术
是否 OOM、每 epoch 多久、创建页小时价。
按需升卡
OOM 或总时长偏向数据中心 → 开 A100;仍不够再 H100。
长训再稳
正式长训再考虑安全云;课题结束删盘。
还没单卡跑稳,不要先开 4 卡。显存紧时优先:梯度检查点、更小 batch、序列裁剪、换精度——再升卡。
常见问题
LoRA 一定要 A100 吗?
不一定。大量图像 LoRA 在 RTX 4090(约 ¥1.19–3.12/小时)可完成。A100 适合显存顶满或更长、更重的微调,不是默认必选项。
微调 7B / 更大规模要哪张?
视精度、序列长度与是否全量 / LoRA 而定。消费级不够再 A100;更高吞吐看 H100;80G 仍紧再 H200。以实际 OOM 与「总时长 × 小时价」为准。
5090 能替代 A100 做 LoRA 吗?
有时可以:5090 约 ¥2.42–4.17/小时,仍属消费级。若瓶颈是数据中心级显存与训练互联,仍应看 A100 及以上。库存可能偏紧。
A100 一小时多少钱?
截至 2026-10-27 快照:A100 PCIe 约 ¥4.17–6.27/小时,A100 SXM 约 ¥4.86–6.27/小时(社区云→安全云)。以控制台实时为准。
训练完忘了关机会怎样?
GPU 运行费会按小时继续扣,直到停止。磁盘也可能继续计费。立刻停止并清盘——见停机还在扣费。